"En ninguna parte alguien concedería que la ciencia y la poesía puedan estar unidas. Se olvidaron que la ciencia surgió de la poesía, y no tuvieron en cuenta que una oscilación del péndulo podría reunirlas beneficiosamente a las dos, a un nivel superior y para ventaja mutua"-Wolfgang Goethe-
Mostrando entradas con la etiqueta Química Analítica. Mostrar todas las entradas

jueves, 24 de agosto de 2017

Linealidad: método del Lack-of-fit

Lo prometido es deuda y he aquí una de las técnicas prometidas en la entrada anterior para el estudio de linealidad. Aunque realmente me gusta dejar claro que esta prueba tiene como cometido principalmente comprobar cuanto error puede aportar a las predicciones la falta de ajuste del modelo. Para hablar de linealidad creo que es preferible comprobar a cada nivel de concentración, porque un modelo que puede parecer globalmente lineal puede no serlo para ciertos niveles de concentración. Pero esa es mi opinión, y por suerte la de muchos.

Debéis disculparme que para esta entrada me ponga en plan técnico más que divulgativo, pero esta entrada tiene fines docentes, y prefiero escribirlo de esta forma.

Partimos de un conjunto de ni puntos de calibración (xi, yi) que presentan una relación lineal aparente, donde se considera que los cada valor de xi está exento de error  y los valores de yi están sujetos a errores de medida pero son homocedásticos. Los valores xi deben aparecer replicados, con lo que estarán agrupados en j (1 a nj) niveles con k (1 a nk) replicados en cada nivel, con lo que ni = nj·nk. Los datos pueden ajustarse a un modelo con c parámetros de ajuste (en regresión lineal c = 2) dando lugar a una ecuación del tipo (1). Siendo y la variable dependiente,  x la variable independiente, b1 la pendiente de la recta de regresión y b0 la ordenada en el origen. La función se obtiene fácilmente mediante el método de mínimos cuadrados minimizando la suma de cuadrados de residuales (2), que considerando la replicación se puede escribir como (3), con grados de libertad  (4).


La prueba  F de falta de ajuste o de Lack-of-fit se basa en un análisis de la varianza (ANOVA) de residuales en el que la suma de residuales, SSE, se descompone en componentes de falta de ajuste. SLF, y error puro SPE, (5) y (6) comprobando la influencia del primero en el error de los residuales. En (7) y (8) se muestra la descomposición de los grados de libertad de cada término.


Los cuadrados medios o varianzas pueden obtenerse fácilmente dividiendo las sumas de cuadrados entre sus correspondientes grados de libertad. De este modo se puede tener la siguiente tabla de ANOVA de falta de ajuste.

Tabla de ANOVA de falta de ajuste (Lack-of-fit)
La prueba de falta de ajuste consiste en calcular un valor F como el cociente entre la varianza (o cuadrado medio) de falta de ajuste y la varianza de error puro.

La hipótesis nula ha de ser entonces que no existe falta de ajuste, el modelo ajusta de forma adecuada a los datos. Si el valor de F calculado es menor que un F tabulado para α = 0.05 (95% de nivel de confianza), nj-c grados de libertad para el numerador y ni-nj grados de libertad para el denominador, se acepta la hipótesis nula. En caso contrario se rechaza y se dice que existe falta de ajuste.

Aunque os parezca tedioso, el cálculo es muy simple y se puede hacer en hoja de cálculo:

1) Obtener SSE a partir de cálculos de regresión o según la fórmula tabla.
2) Obtener SPE según la fórmula de la tabla.
3) Obtener SLF despejando en (5).
4) Dividir entre los grados de libertad indicados en la tabla para obtener MSLF y MSPE.
5) Obtener el F calculado según (9)
6) Comparar con el valor tabulado de F.

Una ventaja de este método es que está implementado en muchos entornos y software como Minitab, R, Statistica, entre otros.

Espero sea de utilidad. Más adelante hablaré del método %RE-plot, propuesto por nosotros, como ya he indicado.

CONTINUARA

sábado, 5 de agosto de 2017

Sobre linealidad en el rango de calibración analítica

Desde hace unos días he mencionado varias veces un trabajo sobre linealidad en el rango de calibración analítica [1]. Creo que es necesario explicar algunas cuestiones sobre este parámetro de calidad de un método. Una comparación detallada de los distintos métodos para evaluar la linealidad se puede encontrar en un trabajo previo [2] de uno de los autores, Francisco Raposo, y, de hecho, fue el punto de partida para despertar mi interés en este tema. Tengo que agradecer al Dr. Raposo por las discusiones previas que me llevó a plantearme este trabajo y fructificó en una colaboración, por haber insistido en intentarlo en una gran revista como Talanta y por haberse encargado él de la última parte de la revisión (muy luchada) en estos momentos en los que me daba por vencido. El tiempo nos dirá si nuestra propuesta es útil o no.

Cuando somos estudiantes y comenzamos a realizar ajustes lineales en nuestras prácticas de laboratorio nos gusta mucho que el coeficiente de correlación (r) o el de determinación (r^2) sean próximos a la unidad. Si eso es así, nuestra respuesta es lineal... Falso, simplemente si nos aceramos a la unidad podemos asegurar que el modelo empleado para ajustarse a nuestros datos es bueno, pero no que sea el mejor. Este parámetro informa sobre como es de pequeña la suma de cuadrados de residuales, pero no indica como se distribuyen los mismos. Por eso no se recomienda el empleo del coeficiente de correlación o determinación como sinónimo de linealidad. Habría que observar la distribución de los residuales.

Este valor de r^2 puede darse por válido en una práctica, pero sería un error. Si se observa con detalle, los puntos se distribuyen de forma no lineal

Otro parámetro muy usado, que yo he usado mucho para no recurrir al valor de r, es el de linealidad on-line [3], que se calcula como 100 menos la desviación estándar relativa de la pendiente. La desviación estándar de la pendiente aumenta cuando aumenta el error estándar de residuales, con lo que estamos en una caso parecido a hablar de coeficientes de correlación, es decir, te da cuenta del porcentaje de ajuste de acuerdo al error de la pendiente, pero no te dice como se distribuyen los puntos alrededor de la recta de calibración. 

Fórmula de la linealidad on-line

¿Cuál es la solución? Como siempre digo a mis alumnos, lo primero que ha de hacerse cuando se tienen datos en el laboratorio es pintarlos en un papel. Hay que hacer una gráfica, siendo a veces la inspección visual lo que da idea, si los datos se distribuyen bien alrededor de la función ajustada, de si el modelo elegido es el adecuado. Supongamos el modelo lineal, a veces es difícil ver la distribución sobre la misma recta y es preferible usar un gráfico de residuales. Este tipo de gráficos es muy interesante, porque puede indicar que la función elegida no es adecuada simplemente con observar la distribución de los residuales. También puede indicar que la distribución no es homocedástica, lo que implicaría el uso  de un modelo ponderado. Pero si tenemos un gráfico de residuales ¿cómo establecemos el límite que pueda indicar  que un punto está fuera de la tendencia de los demás. Para eso es interesante trabajar con residuos estandarizados. Hay muchas formas de estandarizar, pero nosotros proponemos los residuos Studentizados. Si un residuo supera el valor de 1.96 (aproximamos a 2), se considera que el valor es sospechoso se denomina valor extremo (outlier) si supera el 3. Para aceptar un modelo no debe haber valores sospechosos a lo largo del rango de calibración.

Gráficos de residuales Studentizados correspondiente a la recta anterior. Aunque todos están dentro de los límites se observa una distribución de los mismos que indican la idoneidad de un modelo no lineal

Otra opción es el gráfico de linealidad o de factor de respuesta, que se hizo conocido gracias a Huber [4]. Desde mi punto de vista, este método da cuenta del la variación del factor de respuesta (señal debida al analito dividida entre su cantidad o concentración) a lo largo del rango de calibración, pero poco más. Huber establece unos límites del 5% por encima y por debajo de la mediana de los factores de respuesta y establece la linealidad en el rango en que los puntos se mantienen entre esos límites. Esto funciona generalmente bien en métodos cromatográficos, pero no es así en métodos espectroscópicos. Además no tiene en cuenta que las desviaciones de los factores de respuesta pueden ser muy grandes si trabajamos a concentraciones muy pequeñas. no obstante es un método muy útil para observar cambios en la respuesta del método. 

Se puede observar que el gráfico de factor de respuesta (C) falla en este caso 

El método del lack-of-fit (falta de ajuste)  no lo incluimos en el trabajo. Podéis ver una explicación del mismo en aquellos apuntes de Excel que compartí hace años. Aunque esta entrada en el blog es una declaración de intenciones y quiero trabajar en un par de entradas más sobre linealidad. En la primera describiré exclusivamente el método de lack-of-fit y en la segunda el procedimiento que hemos denominado %RE-plot, el gráfico de errores relativos recalculados.


CONTINUARA...


Referencias

[1] J. M. Jurado, A. Alcázar, R. Muñiz-Valencia, S. G. Ceballos-Magaña, F. Raposo, Some practical considerations for linearity assessment of calibration curves as function of concentration levels according to the fitness-for-purpose approach, Talanta, 2017, 172, 221-229.
[3] L. Cuadros Rodríguez , A. M. García-Campaña , C. Jiménez, M Román, Estimation of performance characteristics of an analytical method using the data set of the calibration experiment, Analytical Letters, 1993, 26,1243-1258.
[4] L. Huber, Validation of analytical methods: review and strategy, LC-GC Europe,1998, 11,  96-105.

jueves, 13 de abril de 2017

Sensibilidad de un método analítico y límite de detección

La sensibilidad de un método analítico se define de acuerdo a la IUPAC como la pendiente de la curva de calibración, tratándose de una característica del método que depende sólo del proceso de medida. Así definida, la sensibilidad no es otra cosa que el factor de respuesta, o lo que es lo mismo, el cociente entre la variación de señal asociada a un determinado analito y la variación de su concentración o cantidad (si tuviésemos un solo patrón simplemente es el cociente entre señal y concentración del mismo). La definición es muy clara pero, sin embargo, cuando se presentan las características de un método analítico en publicaciones académicas y científicas se opta normalmente por usar el límite de detección. Pocos autores hablan de sensibilidad dando el valor de la pendiente de calibración, y aquí quiero explicar el motivo de ello.  

El límite de detección (LOD, limit of detection), expresado como la cantidad o concentración, proviene de  la señal más pequeña que puede detectarse con razonable certeza en un determinado procedimiento analítico (IUPAC). Según esto, se trata de la cantidad asociada a la mínima señal que pueda atribuirse al analito, es decir, que sea distinguible de la señal del blanco de medida.  Esa señal mínima se suele definir como la señal del blanco más tres veces la desviación estándar del blanco:


Si en esta expresión se usase la señal del blanco más diez veces su desviación estándar estaríamos defiendo la señal correspondiente al límite de cuantificación (LOQ, limit of quantification), la mínima cantidad cuantificable. Pero en esta entrada nos centraremos en el límite de detección.

Imaginemos que tenemos una recta de calibrado externo del tipo Y = b·X + a, donde Y es la señal correspondiente a una concentración de analito X, b es la pendiente y a es la ordenada en el origen. Si se ha corregido la señal del blanco de los patrones de calibración en la recta anterior, la ordenada en el origen tendrá un valor de cero (a = 0). Ahora debemos sustituir la señal del límite de detección en la ecuación de la recta, pero será la señal corregida, es decir la señal correspondiente al límite de detección menos la señal del blanco:


Esta expresión para el límite de detección es muy común en técnicas de espectroscopia atómica, en las que a baja concentración puede asumirse una ordenada en el origen prácticamente nula. existen otras formas de expresar los límites de detección, pero en todo caso siempre se trata de un parámetro con unidades de señal (en nuestro caso la desviación estándar del blanco) dividido entre el factor de respuesta (la pendiente de la recta de calibrado), cuyas unidades son de señal dividido por concentración. De esta forma siempre se tiene un limite de detección con unidades similares a las de los patrones de calibrado. En otras ocasiones se usa, en lugar de la desviación estándar de la señal del blanco, la desviación estándar de residuales, la de la ordenada en el origen o la desviación estándar de la linea base. Lo importante es que el LOD quede expresado en unidades de concentración, y tras los siguientes ejemplos veremos el porqué.  

a) Comparación de la sensibilidad de una técnica para distintos analitos

En esta comparación voy a usar datos publicados en el trabajo Direct determination of copper, lead and cadmium in aniseed spirits by electrothermal atomic absorption spectrometry, publicado en Food Chemistry en el año 2007, como fruto de mi tesis doctoral: Caracterización analítica de aguardientes anisados.  Vamos a considerar dos ejemplos, un caso donde la diferencia de sensibilidad es obvia y otro en que parece obvia, pero no lo es tanto.

Ejemplo 1. Determinación de cobre y cadmio mediante espectroscopia de absorción atómica con atomización electrotérmica.

El  método propuesto para ambos elementos incluyen una dilución de la muestra en una mezcla de agua / etanol / ácido nítrico (58:40:2) y determinación directa tras un programa optimizado de secado, mineralización y atomización, previa adición del modificador de matriz adecuado. Por lo tanto el calibrado se realiza en una mezcla de los tres componentes en esa misma proporción. 

En el caso del cobre se añade una disolución de nitrato de paladio como modificador de matriz, se seca en dos etapas a 80 y 110 ºC, se mineraliza a 1300 ºC y se atomiza y mide a 2300 ºC. Para el cadmio se emplea una mezcla d nitrato de magnesio y paladio, secando de igual modo que para el cobre. En este caso la mineralización ocurre a 700 ºC y la atomización a 1500 ºC. Las rectas de calibrado tienen las siguientes ecuaciones:

Cu: Y = 0.012·X - 0.001
Cd: Y=0.11·X - 0.004

Siendo Y la señal obtenida y X la concentración en µg/L. Como puede observarse la pendiente de calibración del Cd es casi 10 veces mayor que la del Cu, luego la técnica ETAAS (de electrothermal atomic absorption spectroscopy) es casi diez veces más sensible para Cd que para Cu en estas condiciones de trabajo. El límite de detección debe ser una diez veces más bajo para Cd que para Cu. Los valores calculados como se explica al comienzo de esta entrada  son 0.04 µg/L para cadmio y 0.6 µg/L para cobre, algo más de diez veces menor.  

Ejemplo 2. Determinación de cobre y plomo mediante espectroscopia de absorción atómica con atomización electrotérmica.

La determinación de cobre ya se ha explicado, para el plomo se emplea una mezcla de nitratos de magnesio y paladio, con el mismo secado que para los otros dos elementos, mineralización a 900 ºC y atomización a 1800 ºC. Si se comparan las rectas de calibrado:

Cu: Y = 0.012·X - 0.001
Pb: Y = 0.07·X + 0.000

A primera vista la técnica parece casi el doble más sensible para cobre que para plomo. Pero, ¿que hemos olvidado? Hemos olvidado el error asociado a la pendiente, que esta relacionado con el ruido de fondo que afecta a toda medida. En el caso del cobre el error es de ± 0.004 (33%) y para plomo ± 0.001 (14%). Esto se debe a que la señal del fondo para cobre es más acuciada que para plomo.

Señales obtenidas para cobre y plomo, así como señal de fondo. La señal que se emplea en el calibrado es el área de pico, cuyas unidades son unidades de absorbancia por segundo (u.a.·s) 

Esto hace que cuando se obtienen los límites de detección se encuentre 0.6 µg/L para cobre y 0.7 µg/L para plomo. En realidad no son tan diferentes, puesto que la desviación estándar del blanco es mayor en el caso del cobre y esto hace que, aunque su pendiente sea mayor, no se aprecie un límite de detección mucho menor. Por ese motivo es necesario conocer el error de la pendiente si se quieren comparar sensibilidades o bien realizar el cálculo de los límites de detección.
  

b) Comparación de la sensibilidad de dos técnica diferentes

Para este ejemplo compararemos la determinación de cobre en aguardientes mediante espectroscopia de absorción atómica con atomización electrotérmica (ETAAS) y la determinación del mismo elemento en tequila mediante espectroscopia de emisión atómica de plasma acoplado inductivamente (ICP-AES, de inductively coupled plasma atomic emission spectrometry). Los datos del segundo caso han sido obtenidos de la tesis de Silvia Ceballos Magaña, titulada "Caracterización analítica de destilados de Agave Tequilana mediante técnicas de análisis multivariante". En este caso se digiere una cantidad de muestra en un microondas usando ácido nítrico como oxidante y pentóxido de divanadio como catalizador. Las rectas de calibrado tienen las siguientes ecuaciones:

Cu (ETAAS): Y = 0.012·X - 0.001
Cu (ICP-AES): Y = 2.52·X - 0.13

En principio puede parecer que la técnica ICP-AES es unas 200 veces más sensible que la ETAAS para la determinación de cobre, pero, ¿qué hemos olvidado? Hemos olvidado decir cuales son las unidades de dichas pendientes. En el caso de ETAAS, como la señal viene en u.a.·s y la concentración en µg/L, las unidades de la pendiente son u.a.·s·L/µg. En el caso del ICP-AES, las señales en el equipo de medida vienen dadas en kilocuentas (kcuentas) y las concentraciones de la recta de calibrado en mg/L, así la pendiente viene dada en kcuentas·L/mg. Obviamente no se puede comparar las pendientes con unidades diferentes. Por eso se hace necesario el cálculo de los límites de detección en las mismas unidades. 

Cuando se obtienen los límites de detección se observa que para ETAAS el LOD del cobre es de 0.6 µg/L y para ICP-AES es de 3 µg/L. Es decir, para cobre medido mediante ICP-AES el límite de detección es aproximadamente  5 veces mayor que cuando se mide mediante ETAAS. La espectroscopia de absorción atómica con atomización electrotérmica es más sensible que la espectroscopia de emisión atómica de plasma acoplado inductivamente para la determinación de cobre en estas condiciones experimentales.

Conclusión

Aunque la IUPAC define la sensibilidad como la pendiente de la recta de calibrado (o factor de respuesta), existen situaciones donde es mejor usar los límites de detección para comparar este parámetro de calidad del método. De hecho, es lo que recomiendo siempre. 

Espero que estos ejemplos hayan sido ilustrativos.

domingo, 2 de octubre de 2016

Regresión lineal múltiple con Excel: resolución de mezclas en espectroscopia molecular

Allá por julio de 2015 proponía una entrada sobre la resolución de sistemas de ecuaciones con Excel en la que se usaba como ejemplo la cuantificación en una mezcla de dos sustancias, previa medida de patrones de ambas sustancias por separado. Aquel era un ejemplo simplista, fácil de encontrar en manuales de Química Analítica. A veces la realidad es otra, y para resolver una mezcla de dos o más sustancias no basta con medir los patrones de cada una por separado para obtener unos coeficientes de absortividad molar y resolver así el sistema de ecuaciones. Generalmente se suele medir una serie de patrones, mezcla de los componentes a determinar, registrando la absorbancias a varias longitudes onda. Con estos datos se puede obtener un modelo de regresión lineal múltiple que permita relacionar mediante una función la concentración de cada analito con las absorbancias medidas a las distintas longitudes de onda y cuantificarlos así en una muestra.

El siguiente ejemplo es una simulación hecha en Excel para tres componentes (C1, C2 y C3) en concentraciones molares, midiendo la absorbancia (A1, A2, A3) a tres longitudes de onda. En la simulación se ha empleado un error aleatorio para las señales de un 2% de media. 

C1 C2 C3 A1 A2 A3
0.0075 0.0075 0.0075 1.076 1.08 0.646
0.0025 0.0075 0.0075 0.55 0.965 0.64
0.0075 0.0025 0.0075 0.981 0.615 0.591
0.0025 0.0025 0.0075 0.475 0.55 0.63
0.0075 0.0075 0.0025 1.031 0.96 0.346
0.0025 0.0075 0.0025 0.54 0.91 0.325
0.0075 0.0025 0.0025 0.936 0.55 0.316
0.0025 0.0025 0.0025 0.465 0.435 0.285
0.005 0.005 0.005 0.736 0.775 0.465
0.005 0.005 0.005 0.731 0.785 0.465

Los datos se introducen en la matriz A1:G11, incluyendo encabezados de columna y fila.

Datos de calibración para el ejemplo propuesto


 Tendremos que construir tres modelos de regresión lineal múltiple, uno por cada analito, para relacionar las absorbancias medidas (variables independientes en nuestro modelo) con las concentraciones (variables dependientes). Para ello empleamos la fórmula matricial =ESTIMACION.LINEAL(). 

En el caso de C1, seleccionamos la matriz K2:N6 e introducimos la fórmula =ESTIMACION.LINEAL() desde el menú Formulas/ Insertar función. Como valores de Conocido_y introducimos la matriz B2:B11, que se corresponde con los valores de C1. Como Conocido_x se introducen los valores para A1, A2 y A3, es decir, la matriz E2:G11. Se emplea Constante 1 (VERDADERO) si el modelo contempla un término independiente. En principio lo dejaremos así, si se quisiese obviar se introduce 0 (FALSO). En Estadística introducimos 1 para que calcule errores de los coeficientes, coeficiente de determinación, error de residuales y otros parámetros ya explicados en la entrada sobre regresión lineal en Excel, como el valor F de Fisher, los grados de libertad, suma de cuadrados de regresión y suma de cuadrados de residuales.  Si se prefiere se puede escribir directamente  =ESTIMACION.LINEAL(B2:B11,E2:G11,1,1) con la matriz K2:N6 seleccionada previamente. De cualquiera de las formas, pulsar al mismo tiempo "Ctrl+Shift+Enter".

Formulario de entrada para la función =ESTIMACION.LINEAL()

Si todo ha ido bien, la matriz K2:N6 queda rellena con una serie de valores. En la siguiente figura aparecen dichos valores con unos encabezados explicativos. C1 (en la celda J1) se refiere a la especie 1. C_A1, C_A2 y C_A3 se refiere a los coeficientes que relacionan cada absorbancia con C1. Constant se refiere al termino independiente. En la matriz K2:N2 están los valores de los coeficientes y en la matriz K3:N3 sus errores. El coeficiente de determinación aparece en K4 y el error de residuales en L4. El valor de F, grados de libertad, suma de cuadrados de regresión y suma de cuadrados de residuales aparecen en K5, L5, K6 y L6, respectivamente. Además, más abajo, se incluye el valor calculado de t (valor del coeficiente dividido entre su error) y la probabilidad p de que ese coeficiente valga cero. La explicación de esta prueba la podéis encontrar en una entrada anterior. En este ejemplo, t se calcula en valor absoluto.

Resultados del modelo de regresión lineal para la especie C1


De acuerdo a la prueba t, el coeficiente para A3 (para una probabilidad de 0.05) podría ser obviado, y el modelo recalculado con menos parámetros. Para no alargar la entrada, las pruebas eleminando coeficientes no han sido realizadas.

Algo que conviene recordar es el hecho que los coeficientes par A1, A2 y A3 aparecen en la matriz de resultados en orden inverso a como estén ordenandas las columnas en los datos.

Los resultados para C2 y C3 se realizarían con la misma función. En mi hoja de cálculo lo hice en K18:N22 y K32:N36, respectivamente.

Resultados para C2 y C3
De esta forma se tienen las ecuaciones:

C1 = 0.0103*A1- 0.0019*A2 - 0.00035*A3 + 0.0009
C2 = - 0.002*A1 + 0.0119*A2 - 0.0032*A3 +0.0006
C3 = 7.15*10^(-5)*A1 - 0.0013*A2 + 0.0164 *A3 + 0.002

Los coeficientes de correlación son de 0.996, 0.992 y 0.992 para los tres modelos. El ajuste parece ser adecuado.

Para comprobar la calidad del modelo se han simulado las absorbancias para tres muestras con concentraciones nominales conocidas de la misma forma que se hicieron los patrones. Con las ecuaciones anteriores se calcularon las concentraciones experimentales. Se calculan recuperaciones como (Valor calculado/valor nominal *100). Se observa que los valores de recuperación oscilan entre 93% y 112%, debido al error aleatorio que se le introdujo a las señales. Estos resultados podrían mejorarse si se incluyese un mayor número de medidas de absorbancias y un mayor número de patrones. Pero ese no es el objeto de esta entrada.

Muestras simuladas con sus concentraciones nominales, señales, concentraciones calculadas con el modelo y recuperaciones.
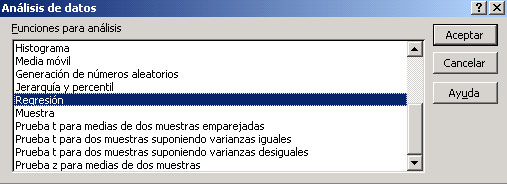
Hemos decidido calcular el modelo con la función matricial =ESTIMACION.LINEAL(), pero el mismo cálculo se podría haber hecho empleando la herramienta de Regresión del complemento Análisis de datos. Por ejemplo, para el compuesto C1:

Herramienta Regresión

Entrada de datos para el compuesto C1
 Hemos seleccionado las matrices de entrada de datos incluyendo el encabezado. Cuando se hace eso es necesario seleccionar Rótulos en el formulario. Ademas se ha seleccionado Residuos y Gráfico de residuales, por si alguien quiere analizar los mismos.
Resultados par C1
La ventaja es que, si se seleccionan los rótulos en el formulario, en la matriz de resultados queda claramente establecido que coeficiente corresponde a cada variable. Además de poder ver el ANOVA y los gráficos de residuales (y la representación de los valores reales y los estimados para los patrones, en caso de seleccionar la Curva de regresión ajustada. Otra ventaja es que se presentan los resultados de significación de cada coeficiente directamente (Probabilidad tras el valor del Estadístico t). En este caso, t no se obtiene en valor absoluto, pero la probabilidad si se obtiene para el valor positivo de t.
Resultados para C1, detalle de los coeficientes
En cuanto a los residuales, es otra ventaja el no tener que calcularlos a mano. En este caso se observa una distribución aleatoria de los mismos.

Detalle de los gráficos de residuales para C1

El mismo procedimiento podría llevarse a cabo para las concentraciones de C2 y C3. La herramienta a emplear es elección de quien realiza los cálculos. Aquí no continuaremos con ello, pero el lector puede comprobar los resultados por sí mismo.

Nota: En este ejemplo hemos generado tres modelos (uno para cada sustancia) que relacionan la concentración de la sustancia con absorbancias medidas a varias longitudes de onda (tres en este caso). Un ejemplo parecido a este, con esta misma forma de proceder se puede encontrar en Miller y Miller, 2002. Está forma de relacionar las variables facilita mucho el cálculo posterior en la muestra, al obtener directamente la concentración de cada analito mediante una función. Si se hubiesen relacionado las absorbancias con las concentraciones podríamos haber obtenido los coeficientes de absortividad molar para cada sustancia a cada longitud de onda. En ese caso, al medir cada muestra nos quedaría  un sistema con tres ecuaciones (tantas como absorbancias medidas) de las que habría que despejar las concentraciones. Esto complica el cálculo, pues primero habría que solucionar el ajuste lineal múltiple y luego el sistema de ecuaciones. Por eso parece más lógico relacionar directamente la concentración de cada sustancia con las absorbancias medidas. Ver: J. N. Miller, J. C. Miller, Estadística y Quimiometría para Química Analítica, Prentice Hall, Madrid, 2002, pp. 239-242

domingo, 1 de mayo de 2016

Separation Science: recursos on-line y de libre acceso

Buscando algo de material para mis alumnos he descubierto la web Separation Science, donde científicos de la talla de  John Dollan, Matthew Klee, Frederick Klink,  David Sparkman, Cari Sänger escriben sobre cromatografía líquida de alta eficacia (HPLC), cromatografía de gases (GC), espectrometría de masas (MS) y electroforesis capilar (CE). Se presentan aplicaciones en el campo del análisis de alimentos, medioambiental, farmacéutico y bioclínico. 


Logotipo de la web Separation Science

La propia web se define como el portal educativo más importante para los usuarios habituales de cromatografía y espectrometría de masas. Creo que merece la pena echarle un vistazo.

miércoles, 27 de enero de 2016

Un tutorial sobre ajuste de datos con Excel

En muchas entradas del blog he ido introduciendo problemas de ajuste de datos con Excel. Con lo cual he ido sacando algunas ideas que puestas en práctica y con ayuda de mis colegas ha quedado reflejado en una publicación en la revista Educación Química, de la Universidad Nacional Autónoma de México. 

En el tutorial se revisan las distintas opciones que presenta Excel para llevar a cabo el ajuste de funciones a datos, como son la obtención gráfica de la ecuación de ajuste, la herramienta de regresión del menú de datos, las funciones de estimación lineal y logarítmica y el empleo de Solver, incluyendo la estimación de errores.

El trabajo es de acceso libre, así que podéis verlo en el enlace Ajustando datos químicos con Excel: un tutorial práctico. Espero os sea útil.

Encabezado del trabajo

viernes, 31 de julio de 2015

Resolviendo sistemas de ecuaciones en Excel

Para ilustrar este procedimiento me van a permitir que use un problema sencillo de los que aparecen en algunos libros de texto de análisis instrumental.

  Se tiene una mezcla de dos especies, A y B, que presentan espectros de absorción parcialmente superpuestos. Calcule la concentración de A y B en la mezcla a partir de los siguientes datos. El espesor de la cubeta de muestra es de 1 cm.


C (M)
A (254 nm)
A (550 nm)
Patrón de A
1.50 x 10 -4
0.003
0.975
Patrón de B
1.80 x 10 -4
0.589
0.017
Mezcla

0.857
0.909

Para resolver el problema, primero se calculan los coeficientes de absortividad molar de A y B a ambas longitudes de onda usando los datos de los patrones por separado. Ya que para cada longitud de onda se cumple la Ley de Beer, se tendrá:

Patrón de especie A:
Patrón de especie B:
Para la mezcla se tendrá el siguiente sistema de ecuaciones:
Si se hubiese llamado Y a la absorbancia, X1 al producto del paso de luz por la absortividad molar  para el compuesto A  y X2 al producto del paso de luz por la absortividad molar de B, el problema se reduce a una calibración lineal múltiple con dos niveles para X1 y X2 (uno por cada longitud de onda a la que se mide) con unos coeficiente a ajustar que se corresponderán con las concentraciones de A y B en la mezcla. Así el modelo lineal múltiple a resolver será:


Aquí es donde entra la función ESTIMACION.LINEAL() de Excel. Para solucionar el sistema de ecuaciones se escribe en una primera columna (columna B en la imagen) los valores de absorbancia de la mezcla a cada longitud de onda. En una segunda columna (C) se escriben los valores para X1 a cada longitud de onda y en la tercera columna (D) lo mismo para X2.


Siguiendo la disposición de las celdas de la figura anterior se selecciona el rango B8:D8 y se inserta la función =ESTIMACION:LINEAL(). En el formulario de entrada se selecciona el rango B2:B3 para la Y y el rango C2:D3 para los valores de X (que son X1 y X2). El cuadro de constante debe aparecer con el valor cero o falso, puesto que el modelo propuesto no presenta término independiente. Esto es lógico si en las medidas de los espectros se ha hecho el cero con el blanco. El apartado de estadística lo pondremos con el valor lógico verdadero, aunque para este tipo de problemas no nos sirve para mucho, puesto que la solución del sistema es única. 


Para terminar pulsamos a la vez Ctrl + shift + enter y apareceran los valores ce CB en B6 y CA en C6. 

¡Cuidado, que si ponemos el orden de las columnas de datos con  la especie A primero y B después, Excel invierte el orden y devuelve primero el coeficiente (concentración en nuestro caso) de B y luego la de A!

Es decir, si ordenamos las columnas de los valores de X poniendo primero X1 y a su derecha X2, Excel devuelve en la matriz de resultados primero el coeficiente de X2 y luego el de X1.


jueves, 4 de diciembre de 2014

Analytical Chemistry 2.0 An Electronic Textbook for Introductory Courses in Analytical Chemistry

 El libro que David Harvey publicaba en McGraw-Hill en 1999 bajo el título Modern Analytical Chemistry es para mí uno de los más claros y mejor escritos para la materia Química Analítica. Mirad que alegría me he llevado al ver que el autor lo ofrece ahora totalmente gratis, revisado y ampliado bajo el nuevo nombre de Analytical Chemistry 2.0. Sin duda todo un regalo a la comunidad científica. ¡Gracias profesor Harvey!


miércoles, 18 de julio de 2012

El efecto matriz

El efecto matriz en Química Analítica se define, de acuerdo con la IUPAC, como el efecto de todos los componentes de la muestra distintos al analito en la medida de una cantidad (de analito). A la hora de aplicar un método analítico, el efecto matriz se traduce en una diferencia de sensibilidad del mismo cuando se prepara un calibrado en un disolvente frente a uno preparado en el mismo entorno de la muestra. La sensibilidad debe entenderse como la variación de la señal analítica frente a la concentración de la especie a determinar, id est la pendiente de la curva de calibrado. Por lo tanto, la diferencia entre las pendientes de calibrado en un disolvente determinado (calibrado externo) y en la matriz de la muestra (ya sea simulada o mediante el método de adición patrón), indica la presencia de efecto matriz, como se apuntaba en un post anterior. Cabe destacar que el efecto matriz es un efecto indeterminado de las especies que rodean a la muestra que afectan a la sensibilidad, cuando el efecto de una especie es determinado (y aditivo) se habla de interferencia. 
En este post vamos a repasar el procedimiento para detectar la presencia de efecto matriz a partir de la comparación entre calibrado externo y calibrado de adición patrón. Por lo tanto el primer paso es preparar una serie de patrones en el disolvente mayoritario de la muestra (agua o el que sea) y un calibrado en la propia muestra añadiendo cantidades conocidas de analito. Como sabemos, procuramos trabajar en un rango de concentraciones en el que la relación señal-concentración sea lineal. Se obtienen las ecuaciones de ambas rectas de calibrado y comparamos las pendientes de las mismas. Si existe efecto matriz, habrá una diferencia significativa entre las pendientes, lo que implica que deberemos trabajar en una matriz simulada o mediante adición patrón.


Centrémonos ahora en llevar a cabo esta comparación de forma estadísticamente correcta. Para ello es preciso conocer el valor de la pendiente de calibrado externo (bCE) y de adición patrón (bAP) además de sus respectivas varianzas (el cuadrado de sus desviaciones estándar). A partir de ahí se calcula la relación entre las pendientes, R (Ecuación 1) y la varianza combinada correspondiente a esa relación (Ecuación 2). Con eso se calcula un valor de t de Student (Ecuación 3).


Lógicamente, se trata de comparar la relación entre ambas pendientes con la unidad. Si dicha relación no difiere de 1, no habrá efecto matriz significativo. Este valor de t calculado se debe comparar con un valor tabulado para los grados de libertad de la varianza combinada. Para conocer estos se debería obtener el número de grados de libertad efectivos de esta combinación. Será preciso emplear la fórmula de Welch-Satterthwaite donde para una varianza combinada (Ecuación 4) se obtienen los grados de libertad efectivos aplicando la Ecuación 5. 


En nuestro caso se obtiene la Ecuación 6:


Donde n se refiere al número de puntos del calibrado externo (CE) o de adición patrón (AP).

Este cálculo es un tanto engorroso, pero una vez realizada una hoja de cálculo de Excel y convenientemente validada, es muy sencillo hacer este tipo de comparaciones. 
No obstante, muchos autores recomiendan la comparación del t calculado con un factor de cobertura k=2 para un 95% de nivel de confianza. Véase González y Herrador (2007). Para que entendamos esta elección, el valor tabulado del estadístico de Student para un número infinito de grados de libertad es de 1.96 para p=0.05 (95% de nivel de confianza). De ahí que se tome un valor de k=2. Esta aproximación puede resultar incluso más restrictiva que el uso del t tabulado para los grados de libertad efectivos.


domingo, 20 de noviembre de 2011

Espectrometría de masas

Os dejo aquí un enlace del servicio de masas de la Universidad de Bristol en la que se explica de forma muy clara fuentes de ionización, detectores, algunos acoplamientos y estudios de fragmentación. Presenta dibujos que aclaran mucho y se explica todo de forma breve.


MASS SPECTROMETRY RESOURCE

viernes, 26 de agosto de 2011

Redes de difracción

He encontrado un Handbook on-line de Richardson Gratings TM que es estupendo para el que esté interesado en este tema. Creo que merece la pena echarle un vistazo.


Diffraction Grating Handbook


lunes, 31 de agosto de 2009

El calibrado y el análisis cuantitativo instrumental

Cuando un químico analítico se enfrenta a una muestra, éste tiene, desde un punto de vista muy general, dos tareas fundamentales: conocer que sustancias forman parte de la materia (análisis cualitativo) y conocer en que cantidad aparecen dichas sustancias (análisis cuantitativo). Centrándonos en esta última, los métodos analíticos empleados pueden ser clásicos, donde se obtiene la cantidad de analito que reacciona estequiométricamente con un reactivo que se añade en cantidad perfectamente conocida a una porción de muestra, o instrumentales donde se mide una propiedad (utilizando un instrumento) que está directamente relacionada con la presencia de analito y cuya intensidad depende de la cantidad del mismo. Es aquí donde debemos introducir el concepto de calibrado. El calibrado en un método instrumental es el proceso mediante el que se obtiene una relación matemática (función analítica) entre la señal del analito y su concentración mediante la comparación con uno o más patrones. Generalmente se trabaja en disolución, con lo que se entiende por patrón a una disolución de analito de concentración perfectamente conocida. Utilizando esta función analítica se puede calcular la concentración de analito en la muestra a partir de la señal medida. La expresión de esta función analítica se corresponde con la ecuación de una curva (curva de calibrado). Siempre que sea posible se busca que la relación entre la señal analítica y la concentración del analito en los patrones sea lineal, obteniendo la línea de mejor ajuste a los datos experimentales obtenidos para los patrones mediante el método de mínimos cuadrados.La IUPAC ofrece guías sobre este tema, para uno (1) o múltiples (2) componentes, siendo recomendable su lectura para profundizar en el tema. Aquí simplemente nombraremos los tipos de calibrado que se suelen emplear en el análisis químico dando unas breves indicaciones de como y cuando se utilizan.

-Calibrado externo

Se lleva a cabo la comparación de señal de analito en la muestra con las obtenidas al medir una serie de patrones preparados. Los patrones suelen ser acuosos (es decir, se disuelve el analito en agua) pero también puede ser recomendable usar una matriz parecida a la de la muestra. Por ejemplo, para la determinación de metales en muestras sólidas, previamente digeridas con ácidos, se suele usar una disolución acuosa con la misma proporción de ácidos que la muestra tratada. En este tipo de calibrado se representa la señal de los patrones frente a su concentración y se obtiene la ecuación de la recta de mejor ajuste. Una vez hecho esto, para calcular la concentración de analito en una muestra se sustituye la señal medida para dicha muestra en la ecuación de la recta y se despeja la correspondiente concentración. Hay que asegurarse de que el valor de señal de la muestra se encuentre entre el mínimo y el máximo de las señales de los patrones (se debe interpolar, no extrapolar) y, si no es así, tratar de diluir la muestra o los patrones, según sea necesario, para que se cumpla este requisito.


Se debe comprobar la presencia de efecto matriz (errores proporcionales, que varían con el nivel de concentración). En caso de existir, hace necesario el uso del método de adición patrón.


- Calibrado por adición patrón

Se realiza añadiendo cantidades conocidas y crecientes de analito a distintas porciones de muestra para construir la curva de calibrado (se debe incluir la muestra sin adición). Se representa la señal obtenida para cada porción frente a la concentración o cantidad añadida a dicha porción. La concentración de la muestra se obtiene como el punto de corte de la prolongación de la recta en el eje de abscisas. Matemáticamente se iguala la señal a cero y se despeja la concentración (cambiando de signo).


Se aplica cuando se observa efecto matriz. Pero, ¿cómo se detecta dicho efecto matriz? Se puede comprobar de forma sencilla representando los datos del calibrado externo y los de adición patrón en el mismo gráfico. Si las rectas son paralelas, es decir, tienen la misma pendiente, no existirá efecto matriz. En caso contrario si habrá efecto matriz.


-Calibrado con patrón interno
En algunas ocasiones, debido a la forma de introducir una muestra en el sistema de medida o a un tratamiento previo de la misma, ésta puede sufrir pérdidas de analito. El problema surge cuando al repetir el mismo proceso una y otra vez las pérdidas de analito son diferentes, con lo que estaremos ante un problema en la repetitividad del método.
Por poner un ejemplo, imaginemos que en el tratamiento de muestra acuosa se realiza una extracción con un volumen X de disolvente orgánico. Ese volumen X se lleva a un volumen final Y y se mide la propiedad proporcional a la cantidad de analito. Quien ha realizado una extracción líquido-líquido sabe que es prácticamente imposible recuperar todo el volumen X en cada extracción. Si en vez de recuperar X recupero X-1 y lo llevamos al mismo volumen final Y, la concentración de analito dependerá del volumen que he recuperado. Este es una caso en el que es aconsejable el uso de un patrón interno. La filosofía de un calibrado con patrón interno es introducir en todas y cada una de las muestras, así como en los patrones, una sustancia en concentración constante (la misma en todas las muestras y patrones) y perfectamente conocida, un patrón interno, que sufra pérdidas de manera análoga al analito. Entre las características básicas de un patrón interno debe estar que sea lo más parecido posible al analito, química y físicamente, y por supuesto, que no sea una especie que ya esté contenida en la muestra originalmente. Ni que decir tiene que debe ser de elevada pureza y estabilidad.

El calibrado se realiza representando el cociente entre la señal obtenida para el analito y la obtenida para el patrón interno frente al cociente de sus concentraciones. Se calculan los parámetros de la recta de calibrado y se sustituye el cociente de señales obtenido para la muestra, obteniendo así el cociente de concentraciones en la muestra. Como conocemos la cantidad de patrón interno añadida, es sencillo calcular la concentración de analito.


Lecturas recomendadas


1) K. Danzer, L. A. Currie. Guidelines for calibration in analytical chemistry. Part 1. Fundamentals and single component calibration. Pure Appl. Chem. 70 (1998) 993-1014) K. Danzer, M. Otto, L. A. Currie. Guidelines for calibration in analytical chemistry. Part 2: Multicomponent calibration (IUPAC Technical Report). Pure Appl. Chem. 76 (2004) 1215-1225


Actualización de la entrada

Debido a un cambio de dirección los links en los comentarios no funcionan bien pero aquí podeis encontrar el link para cálculo de los parámetros de regresión en Excel 2007 y el efecto matriz